AI가 기록을 바꾸는 순간, 왜 ‘안전한 쓰기’가 필요할까?
답변하던 AI가 주문·고객·재고 같은 공식 기록을 직접 바꾸기 시작할 때 무엇이 달라지는지, 조사 수치와 안전 원칙을 바탕으로 살펴봅니다.
- 글쓴이
- 미래이다 운영자
- 발행일
- 최종 확인일
- 2026.09.06 KST
- 확인 범위
- 자료 6건 · Futurum 1H 2026 협업 조사·공식 보안 문서 기반 해석 · 조직별 적용 결과는 확인 필요
먼저 보는 핵심
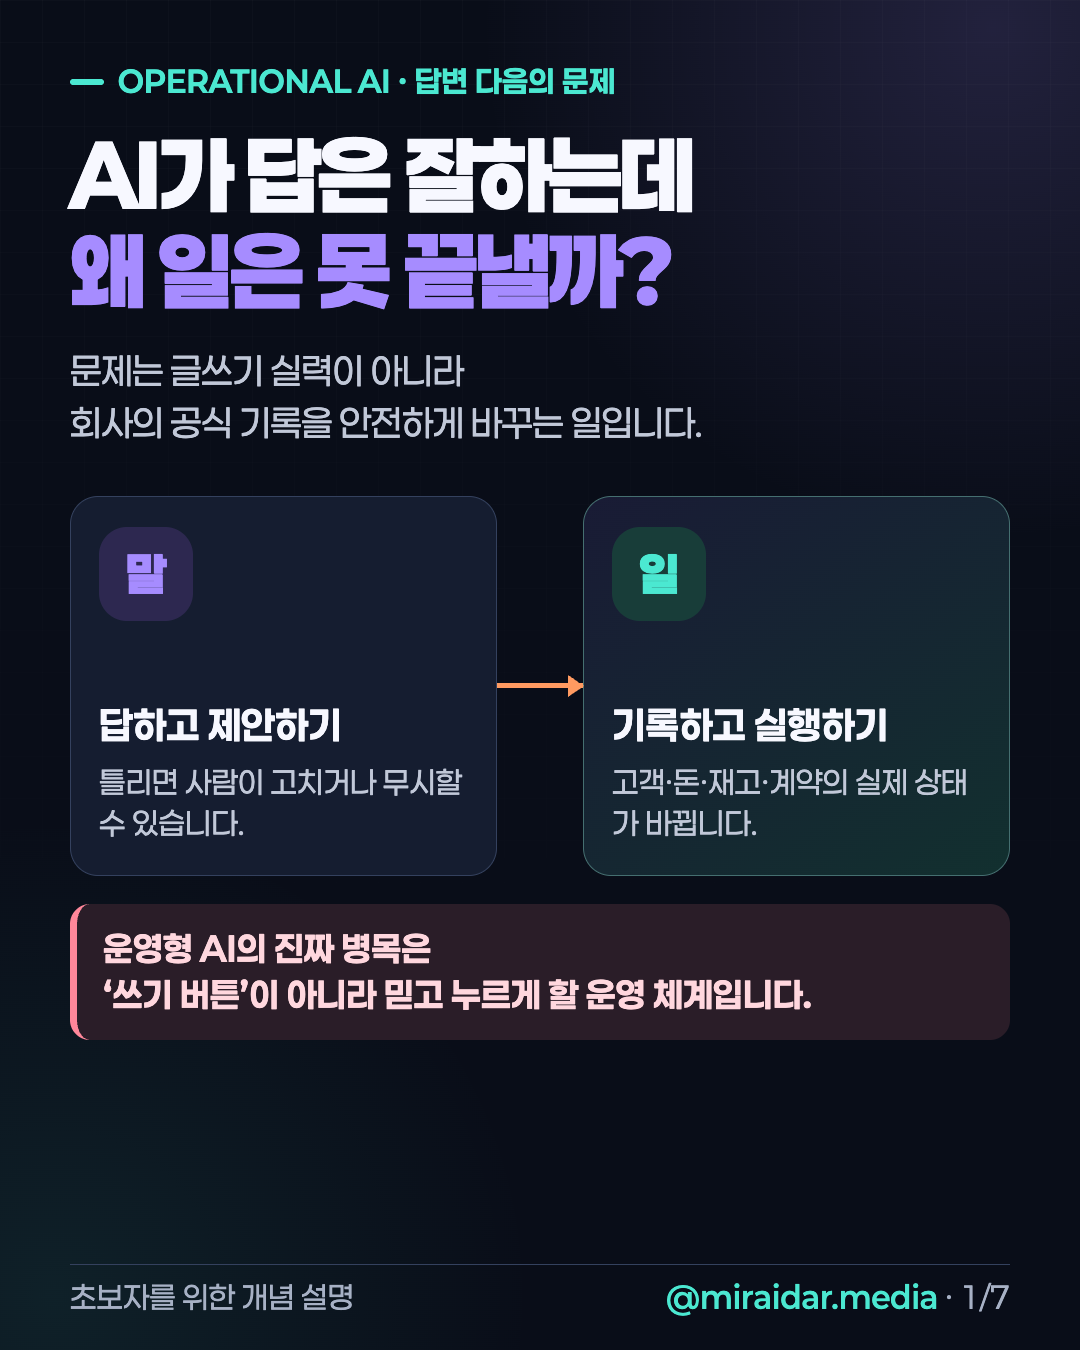
AI가 업무를 끝내려면 공식 기록을 바꿀 수 있어야 하지만, 대상·권한·현재 상태 확인, 인간 승인, 감사 기록, 중복 방지가 먼저 갖춰져야 합니다.
먼저 배경: 답은 했는데 일은 끝나지 않는 이유
AI에게 고객 문의를 보여주면 답장 초안을 만들 수 있습니다. 주문 내역을 읽히면 환불 대상인지 정리할 수도 있고, 재고표를 읽히면 부족한 품목을 알려줄 수도 있습니다.
하지만 초안을 보여주는 것과 실제로 일을 끝내는 것은 다릅니다. 주문 상태를 환불 완료로 바꾸고, 고객 기록을 갱신하고, 재고 수량을 수정하려면 AI가 회사의 공식 기록에 쓰기를 해야 합니다.
여기서 시스템 오브 레코드(system of record)는 주문·고객·재고·회계처럼 조직이 최종 사실로 인정하는 기록 시스템을 뜻합니다.[1] 메모에 “환불 처리”라고 적는 것과 주문 시스템의 상태를 실제로 바꾸는 일은 책임의 무게가 다릅니다.
한 문장으로 답하면
AI가 말하기를 넘어 일을 끝내려면 기록을 바꿀 수 있어야 하지만, 쓰기 권한보다 먼저 안전하게 멈추고 확인하고 되돌아볼 구조가 필요합니다.
읽기는 틀린 답을 사람이 고쳐 쓸 여지가 큽니다. 쓰기는 잘못된 고객, 잘못된 금액, 이미 처리된 주문에 바로 영향을 줄 수 있습니다. 그래서 모델이 더 똑똑해지는 것만으로는 부족합니다.
조사에서 드러난 두 가지 병목
Futurum Group이 1H 2026 웨이브로 발표한 데이터·분석·인프라 조사에는 연매출 1억 달러 이상 조직의 글로벌 의사결정자 818명(n=818)이 참여했습니다. 공개 자료에는 정확한 현장 조사 날짜가 따로 제시되지 않았습니다.[2]
공개 보도자료는 생성형 AI와 에이전틱 AI를 우선하는 응답자 맥락에서 통합 복잡성 29.3%와 기록 시스템에 다시 쓰지 못하는 한계 24.6%를 주요 아키텍처 병목으로 제시했습니다.[2] Snowflake 협업 보고서에서는 이 가운데 쓰기 제한 24.6%를 다시 확인할 수 있습니다.[1]
두 수치는 서로 다른 문제를 보여줍니다.
- 통합 복잡성: 고객·주문·재고 정보가 여러 프로그램에 흩어져 AI가 현재 사실을 한 번에 확인하기 어렵습니다.
- 쓰기 제한: AI가 판단을 내렸더라도 공식 기록을 안전하게 갱신할 연결과 권한이 없습니다.
다만 이 결과를 “전 세계 기업의 24.6%가 모두 같은 문제를 겪는다”는 보편 통계로 읽어서는 안 됩니다. 공개 자료가 설명하는 표본 조건과 조사 우선순위를 함께 봐야 하며, Futurum Group은 Snowflake를 포함한 기술 기업에 조사·분석·자문 서비스를 제공한다고 보고서에 밝히고 있습니다.[1] 따라서 이 수치는 문제의 크기를 확정하는 독립 벤치마크보다, 운영형 AI에서 어떤 마찰이 나타나는지 살피는 신호로 보는 편이 적절합니다.
‘쓰기’가 가능해지면 위험도 달라집니다
AI의 답은 확률적으로 만들어집니다. 그럴듯하지만 틀린 내용을 만들 수 있고, 외부 문서나 이메일에 섞인 지시를 잘못 따를 수도 있습니다. 이런 오류가 읽기 단계에 머물면 사람이 검토할 수 있지만, 쓰기 도구와 넓은 권한이 연결되면 실제 삭제·전송·수정으로 이어질 수 있습니다.[3]
OWASP는 필요한 범위보다 많은 기능·권한·자율성을 AI 시스템에 주는 문제를 과도한 에이전시(Excessive Agency)라고 설명합니다.[3] 필요한 문서를 읽기만 하면 되는 도구에 수정·삭제 기능까지 주거나, 영향이 큰 행동을 별도 확인 없이 실행하는 경우가 여기에 해당합니다.[3]
그래서 중요한 질문은 “AI가 이 일을 할 수 있는가?” 하나가 아닙니다.
누구의 요청으로, 어떤 대상에, 어느 범위까지, 지금 실행해도 되는가?
이 질문의 답은 AI의 말이 아니라 실행 시스템의 규칙으로 확인해야 합니다.[5]
안전한 쓰기에 필요한 네 개의 문
1. 대상을 정확히 확인합니다
고객 이름만 보고 기록을 바꾸지 않습니다. 고객 번호, 주문 번호, 문서 ID처럼 하나로 특정되는 식별자를 사용하고, 대상이 한 건인지 먼저 확인합니다.
예를 들어 동명이인 고객이 있을 때 “김민수 고객의 주소를 수정해 줘”라는 문장만으로 실행하면 잘못된 기록을 바꿀 수 있습니다. 실행 전 화면에는 최소한 대상 ID·현재 값·바뀔 값이 함께 보여야 합니다.
2. 읽기와 쓰기 권한을 분리합니다
최소 권한은 일을 하는 데 꼭 필요한 기능과 범위만 허용하는 원칙입니다. OWASP는 에이전트가 호출할 수 있는 도구와 기능, 연결된 시스템의 권한을 필요한 최소 수준으로 제한하라고 권고합니다.[3]
Microsoft도 문서 요약에는 읽기 전용 권한을, 티켓 작성에는 작성에 필요한 동작만 주고 삭제·관리 권한은 막는 식으로 작업별 범위를 나누도록 안내합니다.[4][5] 한 번 편하게 쓰려고 관리자 권한을 통째로 주면 작은 오류도 큰 사고로 번질 수 있습니다.
3. 현재 상태를 다시 읽고 정책을 검사합니다
처음 요청을 받은 뒤 실행하기까지 몇 초만 지나도 주문이나 재고 상태가 달라질 수 있습니다. 따라서 쓰기 직전에는 대상의 현재 상태를 다시 읽고, “이미 처리됐는가?”, “금액이 승인 범위 안인가?”, “이 사용자가 이 고객 기록을 바꿀 수 있는가?”를 검사해야 합니다.[5]
Microsoft는 이런 정책 계층을 AI 모델 밖의 결정적 규칙으로 두고, 사용자·조직·에이전트·도구·대상 자원·권한·승인 필요 여부를 실행 전에 확인하도록 설명합니다.[5] 모델이 스스로 “해도 된다”고 판단하는 것과 시스템이 실제 권한을 검사하는 것은 다릅니다.
4. 영향이 큰 행동은 인간 승인과 감사 기록을 남깁니다
외부 전송, 결제, 환불, 대량 수정, 삭제처럼 영향이 큰 행동은 실행 직전에 사람이 대상과 변경 내용을 확인할 수 있어야 합니다. OWASP도 고위험 행동에는 인간 승인을 요구하는 통제를 권고하며, 소셜미디어 게시를 사람이 최종 승인하는 사례를 직접 예로 듭니다.[3]
실행 뒤에는 결과를 설명할 감사 기록도 필요합니다. Microsoft는 에이전트 신원, 역할, 실제 권한 범위, 행동, 대상 자원, 연결 ID, 사용자를 대신했는지 여부를 기록하도록 제안합니다.[4] 그래야 문제가 생겼을 때 누가 무엇을 요청했고, 어떤 검사와 승인 뒤에 무엇이 바뀌었는지 다시 찾을 수 있습니다.
같은 요청이 두 번 와도 한 번만 실행되게 합니다
네트워크가 잠시 끊기면 AI는 이전 요청이 성공했는지 모른 채 다시 시도할 수 있습니다. 첫 요청이 실제로 처리됐는데 응답만 늦었다면, 두 번째 요청이 환불·결제·이메일·게시를 한 번 더 실행할 수 있습니다.[6]
이때 필요한 개념이 멱등성(idempotency)입니다. 같은 요청을 여러 번 보내도 최종 결과가 한 번 실행한 것과 같게 만드는 성질입니다.[6]
Google Cloud는 결제 요청이 중복되면 이중 청구가 생길 수 있다는 예를 들고, 각 요청에 고유한 키를 붙여 이미 처리한 요청이면 결과만 다시 돌려주는 방식을 설명합니다.[6] 환불이나 게시처럼 되풀이하면 안 되는 작업도 같은 원칙으로 보호할 수 있습니다.
작은 팀이라면 무엇부터 만들면 될까
거대한 AI 플랫폼부터 만들 필요는 없습니다. 반복 업무 하나를 골라 쓰기 영수증을 먼저 설계해볼 수 있습니다.
- 요청: 누가 무엇을 바꾸라고 했는가?
- 대상: 고객·주문·문서의 고유 ID는 무엇인가?
- 변경 전: 실행 직전의 현재 값은 무엇인가?
- 예정 변경: 무엇이 어떻게 바뀌는가?
- 권한과 정책: 이 요청자와 에이전트가 지금 실행할 수 있는가?
- 승인: 영향이 크다면 누가 최종 확인했는가?
- 중복 방지 키: 같은 요청을 다시 받아도 한 번만 처리되는가?
- 결과: 성공·실패 여부와 실제 변경 뒤 값은 무엇인가?
처음에는 AI가 이 영수증의 초안만 만들고 사람이 실행해도 됩니다. 다음 단계에서는 위험이 낮고 되돌릴 수 있는 한 가지 작업만 자동화합니다. 정확도뿐 아니라 잘못된 대상 선택, 중복 실행, 승인 누락, 되돌리기 시간도 함께 기록하면 자동화 범위를 넓혀도 되는지 판단하기 쉬워집니다.
함께 기억할 한계
- Futurum 수치는 연매출 1억 달러 이상 조직의 의사결정자를 대상으로 한 조사에서 나왔습니다.[2] 개인사업자나 작은 팀의 비율로 그대로 옮길 수 없습니다.
- Futurum의 보고서는 Snowflake와 협업해 작성됐으며, 제품·아키텍처에 관한 일부 평가는 업체와 분석사의 관점을 포함합니다.[1]
- OWASP와 Microsoft 문서는 안전 설계 원칙을 제시하지만, 적용만으로 모든 오류나 공격을 막는다고 보장하지 않습니다.[3][4]
- 실제 통제 수준은 다루는 데이터, 금액, 되돌릴 수 있는지 여부, 관련 법과 조직 정책에 따라 달라집니다.
핵심은 AI에게 쓰기 권한을 빨리 주는 것이 아닙니다. 잘못된 실행을 막고, 중요한 순간에 사람이 멈출 수 있고, 나중에 무엇이 일어났는지 설명할 수 있을 때만 쓰기의 범위를 넓히는 것입니다.
출처
직접 확인한 자료
- Operationalizing Autonomous AI: Architecting the Agentic Enterprise on a Converged Data FoundationFuturum Research · 2026-08 · 기록 시스템 쓰기 제한과 운영형 AI 아키텍처 · Snowflake 협업 보고서
- Enterprise Data Analytics Survey Finds 59% Investing in Semantic LayersFuturum Group · 2026-03-30 · 조사 표본과 29.3%·24.6% 병목 수치
- LLM06:2025 Excessive AgencyOWASP Gen AI Security Project · 과도한 기능·권한·자율성 위험과 인간 승인 권고
- Least privilege for AI agentsMicrosoft Learn · 에이전트 신원·범위·도구 접근·감사 가능성 설계
- Access patterns and controls for AI agentsMicrosoft Learn · 읽기와 쓰기 분리, 실행 전 정책 검사, 감사 추적
- What is idempotency? A guide to API reliabilityGoogle Cloud · 같은 요청의 안전한 재시도와 중복 실행 방지
자료에 나온 주장과 수치를 그대로 확정하지 않고, 확인 범위와 한계를 본문에 함께 밝혔습니다.
KEEP READING